A medida que las cookies de terceros desaparecen gradualmente, el tagging del lado del servidor está ganando terreno como una de las principales alternativas para las empresas con visión de futuro.
En este artículo, abordamos algunas de las preguntas más frecuentes que recibimos sobre el tagging del lado del servidor, para ayudarte a entender de qué se trata.
Actualización de abril de 2025: Didomi ha adquirido Addingwell, una solución de tagging del lado del servidor. Más información en nuestro comunicado de prensa.
¿Cuál es el tagging del lado del servidor?
El tagging del lado del servidor es un método de recopilación de datos en el que las etiquetas de seguimiento se ejecutan en un servidor en lugar de directamente en el navegador del usuario.
Este enfoque traslada la responsabilidad de gestionar los scripts de seguimiento del lado del cliente (el dispositivo del usuario) al lado del servidor (el servidor de la organización). Al hacerlo, ofrece un mayor control sobre el tratamiento de los datos, un mejor rendimiento del sitio web y una mejor conformidad con las normativas de privacidad.
Visita nuestra publicación de blog para una comprensión más profunda del tagging del lado del servidor:
¿Son mutuamente excluyentes el tagging del lado del servidor y el del lado del cliente?
No necesariamente. Muchas empresas utilizan un modelo híbrido, aprovechando el lado del cliente para interacciones inmediatas con el usuario y el lado del servidor para mejorar la privacidad y el control.
¿Cuáles son los principales beneficios del tagging del lado del servidor?
El tagging del lado del servidor reduce el número de scripts de terceros que se cargan en una página web. Este enfoque tiene múltiples beneficios:
- Mejor rendimiento del sitio web: trasladar la lógica de seguimiento al servidor reduce la cantidad de JavaScript que se ejecuta en una página web, lo que se traduce en tiempos de carga más rápidos y mejores Core Web Vitals.
- Mayor control y seguridad de los datos: las organizaciones pueden filtrar, anonimizar y gestionar los datos recopilados antes de compartirlos con terceros, garantizando la conformidad con normativas de privacidad como el RGPD.
- Menor interferencia de los bloqueadores de anuncios: dado que el seguimiento se realiza a través del propio dominio del sitio web y no mediante scripts de terceros, es menos probable que los bloqueadores de anuncios interrumpan la recopilación de datos.
- Mayor vida útil de las cookies: el tagging del lado del servidor permite a las empresas almacenar las cookies como propias (first-party) y HTTP-only, haciéndolas más resistentes a restricciones de navegadores como el ITP de Safari.
- Capacidades analíticas y de marketing mejoradas: unos datos más limpios y fiables mejoran la segmentación de audiencias, la personalización y la eficacia de las herramientas de automatización de marketing.
¿Qué papel desempeña el tagging del lado del servidor en la transición fuera de las cookies de terceros?
El tagging del lado del servidor ayuda a las empresas a transitar hacia estrategias de datos propios (first-party), reduciendo su dependencia de las cookies de terceros para el seguimiento y la personalización. Al procesar los datos en un servidor controlado por la empresa en lugar de en el navegador, permite una atribución más precisa, cookies propias más duraderas y una mejor conformidad con las normativas de privacidad.
A menudo se cita como una de las principales alternativas a las cookies de terceros, junto con las soluciones de identificadores universales, las data clean rooms y las tecnologías de mejora de la privacidad (PET, por sus siglas en inglés), cada una de las cuales ofrece diferentes formas de preservar las capacidades de segmentación y medición mientras se centra en la privacidad del usuario.
¿Cómo mejora el tagging del lado del servidor la privacidad y la conformidad con el RGPD y otras normativas?
El tagging del lado del servidor refuerza la privacidad y la conformidad regulatoria al dar a las organizaciones más control sobre la recopilación, el almacenamiento y el intercambio de datos, reduciendo la dependencia de scripts de terceros y garantizando que el consentimiento del usuario se gestione correctamente:
- Mayor control sobre el tratamiento de datos: con el tagging del lado del servidor, las empresas pueden filtrar, anonimizar o enriquecer los datos antes de compartirlos con proveedores externos, garantizando que solo se transmitan los datos necesarios y consentidos, de acuerdo con los principios de minimización de datos y limitación de la finalidad del RGPD.
- Mayor seguridad de los datos: al procesar los datos de seguimiento en un servidor propio seguro en lugar de directamente en el navegador del usuario, las empresas reducen su exposición a vulnerabilidades del lado del cliente, como el acceso no autorizado de terceros, las filtraciones de datos y los scripts maliciosos.
- Mejor conformidad con los requisitos de consentimiento: el tagging del lado del servidor funciona junto con una plataforma de gestión del consentimiento (CMP) para garantizar que las decisiones del usuario se respeten antes de compartir cualquier dato, evitando así un tratamiento de datos no conforme.
- Menor dependencia del seguimiento por terceros: dado que los datos se procesan dentro de la propia infraestructura de la empresa, las empresas pueden limitar el acceso incontrolado de terceros a los datos, reduciendo el riesgo de incumplimiento y mejorando la transparencia.
Consulta nuestra página dedicada para saber más sobre cómo el lado del servidor podría ser adecuado para tu organización:
{{server-side-tagging-page}}
¿Cuál es el impacto del tagging del lado del servidor en el seguimiento y la atribución publicitaria?
El tagging del lado del servidor mejora el rendimiento publicitario al permitir un mejor enriquecimiento de los datos propios, un seguimiento más fiable y una mayor precisión en las conversiones.
¿Qué desafíos deben anticipar las empresas al adoptar el tagging del lado del servidor?
Los principales desafíos que las organizaciones deben esperar al implementar una configuración del lado del servidor son:
- Costes de infraestructura y mantenimiento: ejecutar una configuración de tagging del lado del servidor requiere recursos en la nube adicionales, que pueden resultar costosos de mantener en comparación con el seguimiento tradicional del lado del cliente.
- Complejidad técnica y experiencia necesaria: implementar y gestionar el tagging del lado del servidor requiere conocimientos especializados, a menudo con la participación de desarrolladores e ingenieros de datos.
- Gestión continua y resolución de problemas: a diferencia del tagging del lado del cliente, que es más sencillo de implementar, las configuraciones del lado del servidor requieren supervisión, actualizaciones y depuración continuas para garantizar un funcionamiento fluido.
- Preocupaciones sobre transparencia y auditabilidad: dado que los datos se procesan en el servidor antes de compartirse con los proveedores, las empresas necesitan un registro, informes y medidas de conformidad claros para satisfacer a los reguladores, como la CNIL francesa.
- Desafíos de integración: garantizar la compatibilidad con las herramientas analíticas, de marketing y las plataformas de gestión del consentimiento (CMP) existentes puede requerir configuraciones personalizadas y esfuerzo de desarrollo adicional.
- Responsabilidades regulatorias y de gobernanza de datos: con un control total sobre la recopilación de datos, las empresas asumen una mayor responsabilidad en materia de conformidad con la privacidad, lo que hace crucial contar con políticas de gobernanza sólidas.
¿Sigue siendo necesario el consentimiento del usuario en una implementación del lado del servidor?
Sí. Los requisitos de consentimiento del usuario en virtud del RGPD y otras normativas de privacidad de datos siguen siendo los mismos, ya se implementen las etiquetas del lado del cliente o del lado del servidor. El método de recopilación no cambia las obligaciones de conformidad.
Por consiguiente, una plataforma de gestión del consentimiento sigue desempeñando un papel fundamental en una implementación del lado del servidor, garantizando una recopilación y gestión adecuadas del consentimiento antes de que se produzca cualquier tratamiento de datos.
Para saber más, consulta nuestro artículo sobre el impacto del seguimiento del lado del servidor en la gestión del consentimiento, basado en un seminario web organizado conjuntamente con digitalinkers:
¿Cuál es la diferencia entre el tagging del lado del servidor y el del lado del cliente?
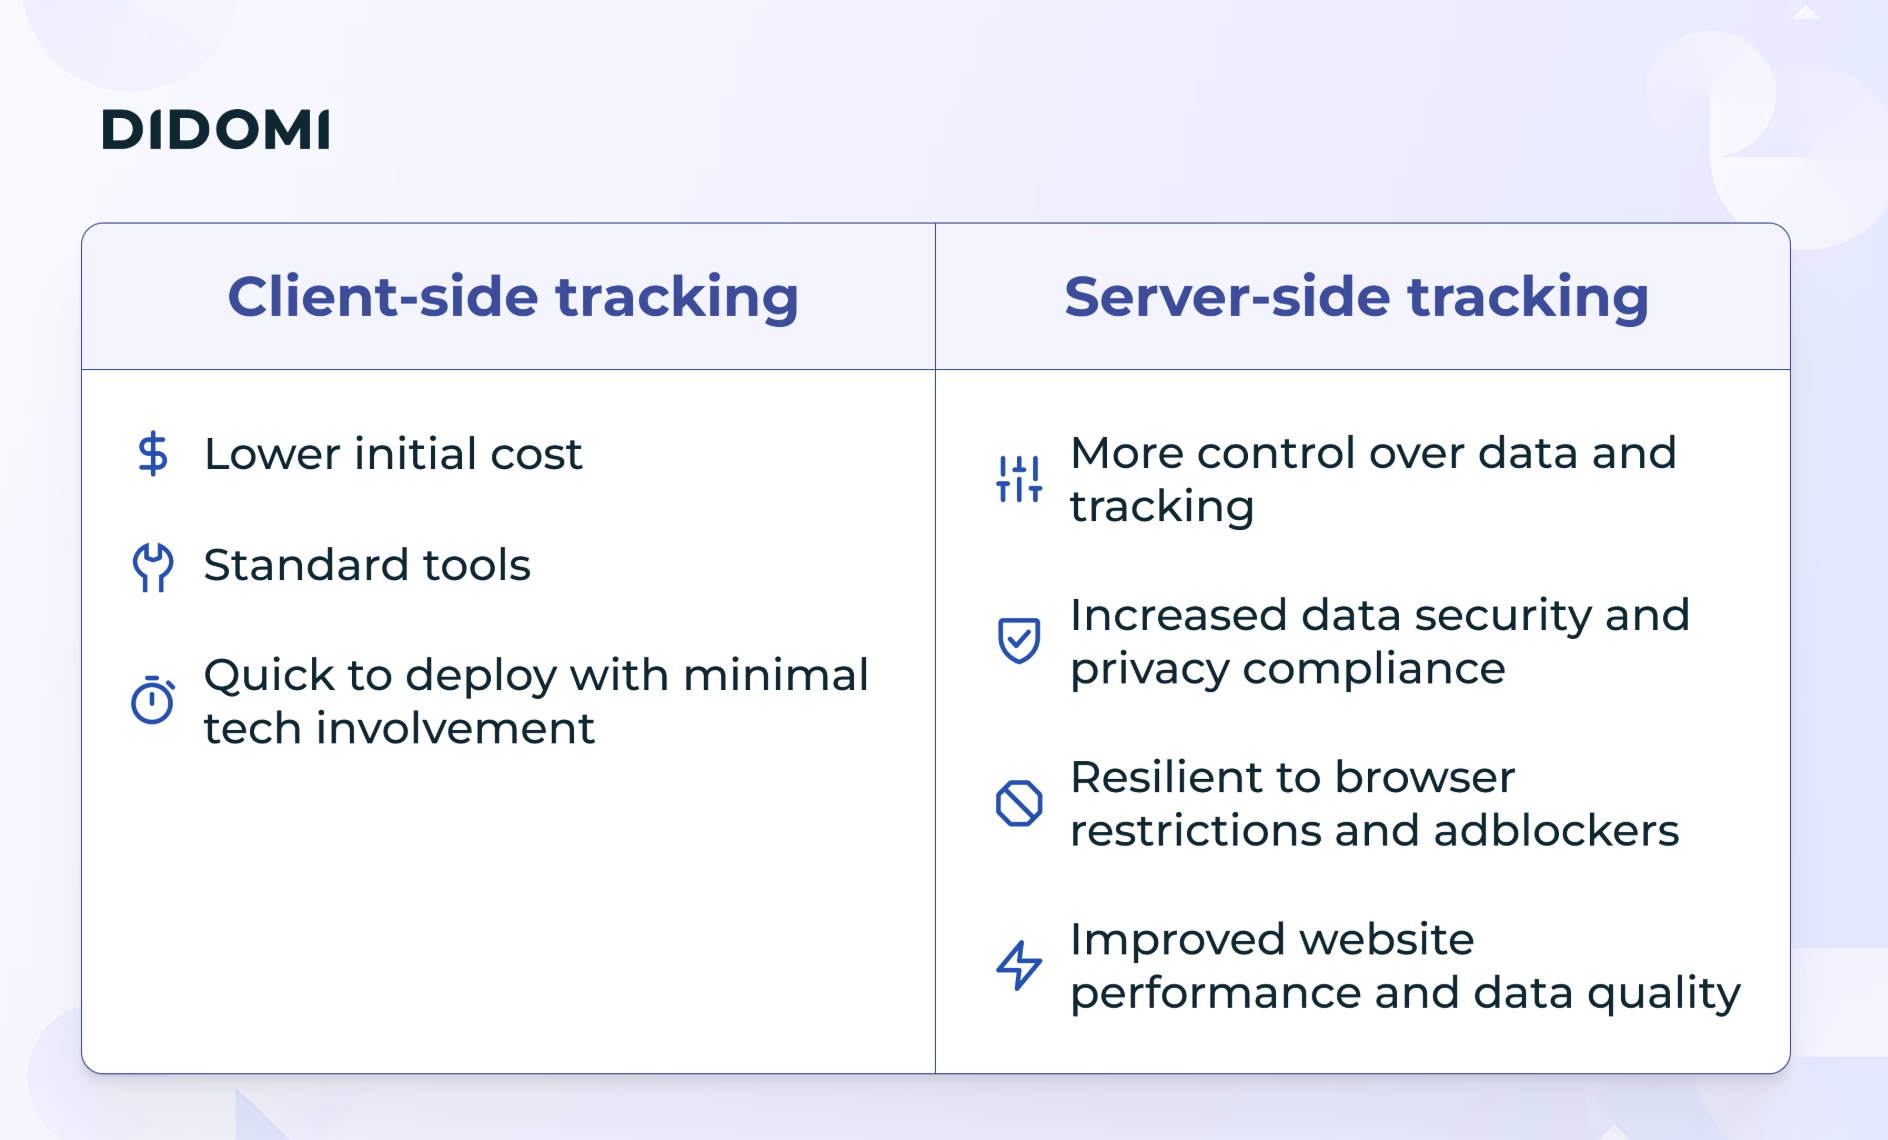
La diferencia entre el tagging del lado del cliente y el del lado del servidor se resume en lo siguiente:
- En una integración del lado del cliente, todo se realiza en el navegador del usuario, donde se activan las etiquetas y se depositan las cookies.
- En una integración del lado del servidor, se añade un servidor intermediario, lo que permite al cliente trasladar la lógica de activación de etiquetas a un flujo de trabajo de máquina a máquina en el que ya no se necesitan cookies. La ventaja es la capacidad de añadir una lógica completa de servidor a servidor, además de la lógica de cliente-servidor-servidor.
Consulta el siguiente elemento visual para tener una visión rápida de las diferencias entre ambos, y lee nuestro artículo completo sobre el tagging del lado del servidor frente al del lado del cliente para saber más:
¿Qué es una arquitectura de datos de servidor a servidor?
Una arquitectura de servidor a servidor (S2S) es un marco de procesamiento de datos en el que la información se recopila, enriquece y transmite directamente entre servidores, en lugar de depender del navegador o el dispositivo del usuario para el seguimiento y el intercambio de datos.
Este enfoque refuerza el control de los datos, la seguridad y la conformidad, lo que lo hace especialmente valioso para las empresas que deben cumplir con normativas de privacidad como el RGPD y que buscan optimizar la precisión del seguimiento mientras reducen su dependencia de scripts de terceros. Al trasladar el procesamiento de datos al backend, las empresas pueden minimizar la interferencia de los bloqueadores de anuncios, mejorar la coherencia de los datos entre canales y garantizar una mejor gobernanza de la información sensible.
Para ver un ejemplo real de cómo funciona la arquitectura S2S, descubre cómo SNCF Connect & Tech la implementó para mejorar la fiabilidad de los datos y la conformidad (en ingles):
{{sncf-tech-connect-case-study}}